React 中 useEffect 的误区:不是所有副作用都需要它
刚开始写 React Hooks 的时候,我对 useEffect 有一种很朴素的理解:
只要某段代码需要“在某个值变化之后执行”,就放进
useEffect。
这个理解不能说完全错,但很容易把路带偏。项目稍微复杂一点之后,组件里就会出现一堆 effect:同步 props、处理表单默认值、拼接口参数、更新派生状态、触发回调、修正另一个 state。每个 effect 单独看都像是有理由的,合在一起就变成了一个很难推的状态机器。
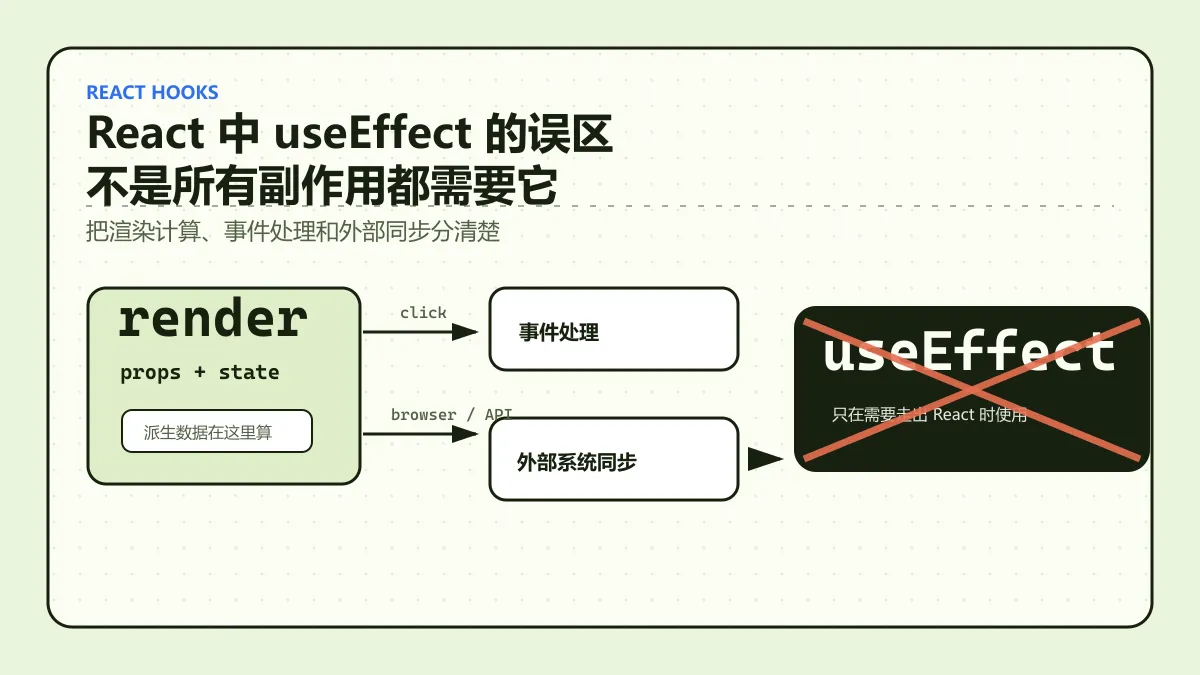
后来我慢慢意识到,useEffect 不是“响应式语法”,也不是“状态变化监听器”。它真正适合处理的是组件和外部系统之间的同步,比如请求数据、订阅事件、操作浏览器 API、连接 WebSocket、写入 localStorage。至于组件内部能通过渲染过程算出来的东西,很多时候根本不需要 effect。
一个很常见的多余 effect
先看一个例子:
function ProductList({ products, keyword }: Props) {
  const [filteredProducts, setFilteredProducts] = useState<Product[]>([]);

  useEffect(() => {
    setFilteredProducts(products.filter((product) => product.name.includes(keyword)));
  }, [products, keyword]);

  return (
    <ul>
      {filteredProducts.map((product) => (
        <li key={product.id}>{product.name}</li>
      ))}
    </ul>
  );
}这段代码很眼熟,甚至看起来挺合理:products 或 keyword 变了,就重新筛选列表。
问题在于,filteredProducts 并不是一个真正独立的状态。它完全可以由 products 和 keyword 推出来。把它放进 state 之后,组件反而多了一轮渲染:先用旧的 filteredProducts 渲染一次,再等 effect 执行 setFilteredProducts,然后再渲染一次。
更直接的写法是:
function ProductList({ products, keyword }: Props) {
  const filteredProducts = products.filter((product) => product.name.includes(keyword));

  return (
    <ul>
      {filteredProducts.map((product) => (
        <li key={product.id}>{product.name}</li>
      ))}
    </ul>
  );
}
如果筛选逻辑真的很重,再考虑 useMemo:
const filteredProducts = useMemo(() => {
  return products.filter((product) => product.name.includes(keyword));
}, [products, keyword]);但这里要注意,useMemo 解决的是“重复计算可能太贵”的问题,不是“所有派生数据都必须缓存”的问题。大部分列表筛选、格式化、拼文案,其实直接写在渲染里就够了。
我现在会用一个很简单的标准判断:
如果一个值能从现有 props 或 state 稳定推出来,它通常不应该再占一个 state。
这个标准能删掉很多不必要的 useEffect。
不要用 effect 同步内部状态
另一个常见场景是“同步状态”:
function ProfileForm({ user }: { user: User }) {
  const [name, setName] = useState('');

  useEffect(() => {
    setName(user.name);
  }, [user]);

  return <input value={name} onChange={(event) => setName(event.target.value)} />;
}
这段代码要看业务语义。
如果这个表单只是展示 user.name,那根本不需要本地 state:
function ProfileName({ user }: { user: User }) {
  return <span>{user.name}</span>;
}
如果它是一个可编辑表单,事情就没那么简单了。用户正在输入的时候,父组件传进来的 user 变了,应该覆盖用户输入吗?如果切换到了另一个用户,表单应该重置吗?如果只是后台刷新了当前用户数据,又该怎么办?
这些问题不是 useEffect 能自动回答的。写成 effect 只是把业务选择藏起来了。
我更喜欢把语义写清楚一点。比如“切换用户时重建整个表单”,可以把 key 放在组件边界上:
function ProfilePage({ user }: { user: User }) {
  return <ProfileForm key={user.id} user={user} />;
}

function ProfileForm({ user }: { user: User }) {
  const [name, setName] = useState(user.name);

  return <input value={name} onChange={(event) => setName(event.target.value)} />;
}
这比在 effect 里监听 user 然后手动 setName 更明确。React 看到 key 变了,会把旧的 ProfileForm 卸载,再创建一个新的。这里的“重置”是组件身份变化带来的结果,不是某个 effect 偷偷修 state。
当然,也不是说同步 props 到 state 永远不行。比如你确实要在弹窗打开时拍一份初始快照,让用户在弹窗里随便编辑,点取消就丢弃。这种场景可以有本地 state。但我会尽量让触发时机跟业务动作绑定,比如“打开弹窗时初始化”,而不是无脑监听 props。
用户操作产生的事情,优先放事件里
有一类 effect 是这样写出来的:
function SaveButton({ form }: Props) {
  const [shouldSubmit, setShouldSubmit] = useState(false);

  useEffect(() => {
    if (!shouldSubmit) return;

    submitForm(form);
    setShouldSubmit(false);
  }, [shouldSubmit, form]);

  return <button onClick={() => setShouldSubmit(true)}>保存</button>;
}
这段代码绕了一圈。保存这件事明明是用户点击按钮触发的,直接写在点击事件里就行:
function SaveButton({ form }: Props) {
  async function handleSave() {
    await submitForm(form);
  }

  return <button onClick={handleSave}>保存</button>;
}
我以前会把这类逻辑放进 effect,主要是觉得“状态变了再执行”比较统一。但后来发现,这样会让代码的因果关系变差。
用户点击按钮,发生保存。这个因果关系很直接。
用户点击按钮,修改 shouldSubmit,组件重新渲染,effect 发现 shouldSubmit 是 true,触发保存,再把 shouldSubmit 改回 false。这个链路就绕了。
事件处理函数天然知道“刚刚发生了什么”。effect 只知道“现在状态是什么”。如果一件事本来就是由某个事件触发的,把它留在事件里,通常更清楚。
真正适合 useEffect 的场景
那 useEffect 到底该用在哪里?
我现在会把它理解成:让组件和 React 之外的东西保持同步。
比如页面标题:
function ArticlePage({ title }: { title: string }) {
  useEffect(() => {
    document.title = title;
  }, [title]);

  return <article>{title}</article>;
}
比如监听窗口尺寸:
function useWindowWidth() {
  const [width, setWidth] = useState(window.innerWidth);

  useEffect(() => {
    function handleResize() {
      setWidth(window.innerWidth);
    }

    window.addEventListener('resize', handleResize);
    return () => {
      window.removeEventListener('resize', handleResize);
    };
  }, []);

  return width;
}
比如根据参数请求数据:
function UserDetail({ userId }: { userId: string }) {
  const [user, setUser] = useState<User | null>(null);

  useEffect(() => {
    let ignore = false;

    async function loadUser() {
      const data = await fetchUser(userId);
      if (!ignore) {
        setUser(data);
      }
    }

    loadUser();

    return () => {
      ignore = true;
    };
  }, [userId]);

  if (!user) return <p>加载中...</p>;

  return <div>{user.name}</div>;
}
这些代码有一个共同点:它们都在跟 React 外部的世界打交道。document、window、网络请求、订阅、计时器、第三方库实例,都不属于 React 的渲染过程。组件需要在合适的时机建立连接,也需要在卸载或依赖变化时清理,这正是 effect 擅长的地方。
依赖数组不是用来“控制执行次数”的
很多 useEffect 的问题,最后都会落到依赖数组上。
我见过不少这样的写法:
useEffect(() => {
  loadData();
}, []);
然后 loadData 里面其实用到了 keyword、page、sort,但依赖数组是空的。这样写的动机通常是“我只想请求一次”。问题是,代码读起来会撒谎:effect 明明依赖了一些值,却没有声明。
短期看,它可能跑得起来。长期看,下一次有人改搜索条件、分页逻辑、默认排序时,很容易遇到旧闭包问题。
依赖数组不是手动调度器。它表达的是:这个 effect 使用了哪些响应式值。用了就应该写进去。写进去之后如果导致重复执行,通常说明逻辑边界需要重新拆,而不是把依赖删掉骗过去。
比如请求数据这件事,如果真的只应该在“点击搜索”时发生,那就让点击事件更新一个明确的查询条件:
function SearchPage() {
  const [keyword, setKeyword] = useState('');
  const [query, setQuery] = useState('');
  const [items, setItems] = useState<Item[]>([]);

  useEffect(() => {
    if (!query) return;

    fetchItems(query).then(setItems);
  }, [query]);

  return (
    <>
      <input value={keyword} onChange={(event) => setKeyword(event.target.value)} />
      <button onClick={() => setQuery(keyword)}>搜索</button>

      {items.map((item) => (
        <div key={item.id}>{item.name}</div>
      ))}
    </>
  );
}
这里 keyword 是输入框里的草稿,query 是已经提交的查询条件。effect 依赖 query,语义就清楚了:只有提交后的查询变化,才请求列表。
当然,在真实项目里我更倾向于把请求交给 React Query、SWR、TanStack Router 这类工具处理。数据请求本身有缓存、竞态、错误重试、刷新策略,用裸 useEffect 写到最后往往会长出一堆边角逻辑。
Strict Mode 下 effect 执行两次不是 bug
开发环境里还有一个容易让人困惑的点:React Strict Mode 会让 effect 在开发阶段多执行一次。
这不是 React 闲着没事多调一遍,而是在帮你发现没有正确清理的副作用。
比如下面这段代码:
useEffect(() => {
  socket.connect();
}, []);
如果没有清理逻辑,组件重新挂载或开发环境重复检查时,就可能留下多余连接。更完整的写法应该是:
useEffect(() => {
  socket.connect();

  return () => {
    socket.disconnect();
  };
}, []);
我以前遇到过一个页面,开发环境下接口请求看起来发了两次,第一反应也是去想办法“阻止 effect 执行两次”。后来排查才发现,真正的问题是 effect 里做了不该重复做的事,而且没有把清理和幂等处理想清楚。
一个 effect 如果不能接受挂载、清理、再次挂载的过程,通常说明它和外部系统的同步关系还没有写完整。
我会先问自己的几个问题
现在写 useEffect 之前,我一般会停一下,问几个问题:
- 这段逻辑是在同步外部系统吗?
- 这个值能不能直接从 props 或 state 算出来?
- 这件事是不是由一次明确的用户操作触发?
- 这个 state 是独立状态,还是派生状态?
- 如果依赖数组写完整,会不会暴露出当前逻辑拆分不合理?
- 这个 effect 有没有对应的清理逻辑?
如果答案指向“它只是组件内部数据流的一部分”,我会先尝试不用 effect。很多时候,删掉 effect 之后代码反而更短,也更容易读。
最后
useEffect 本身没有问题。真正麻烦的是,我们太容易把它当成万能补丁:渲染里算不清楚,就塞 effect;事件里懒得处理,就塞 effect;状态设计绕住了,也塞 effect。
短期看,页面动起来了。长期看,组件会变得越来越难推:一个 state 改了,触发哪个 effect,哪个 effect 又改了另一个 state,最后为什么多请求一次、为什么闪了一下旧数据、为什么表单被重置,都会变成排查成本。
我现在更愿意把 useEffect 当成最后一步:当代码真的需要走出 React,去同步浏览器、网络、订阅或第三方系统时,再用它。
能在渲染里算出来的,就在渲染里算。能在事件里说明白的,就放事件里。能通过组件边界和 state 结构表达的,就别交给 effect 暗中修补。
这样写出来的 React 代码,不一定显得更“高级”,但通常更稳,也更容易改。