把博客自动部署到 GitHub Pages:从 CI 到自动发布的踩坑记录
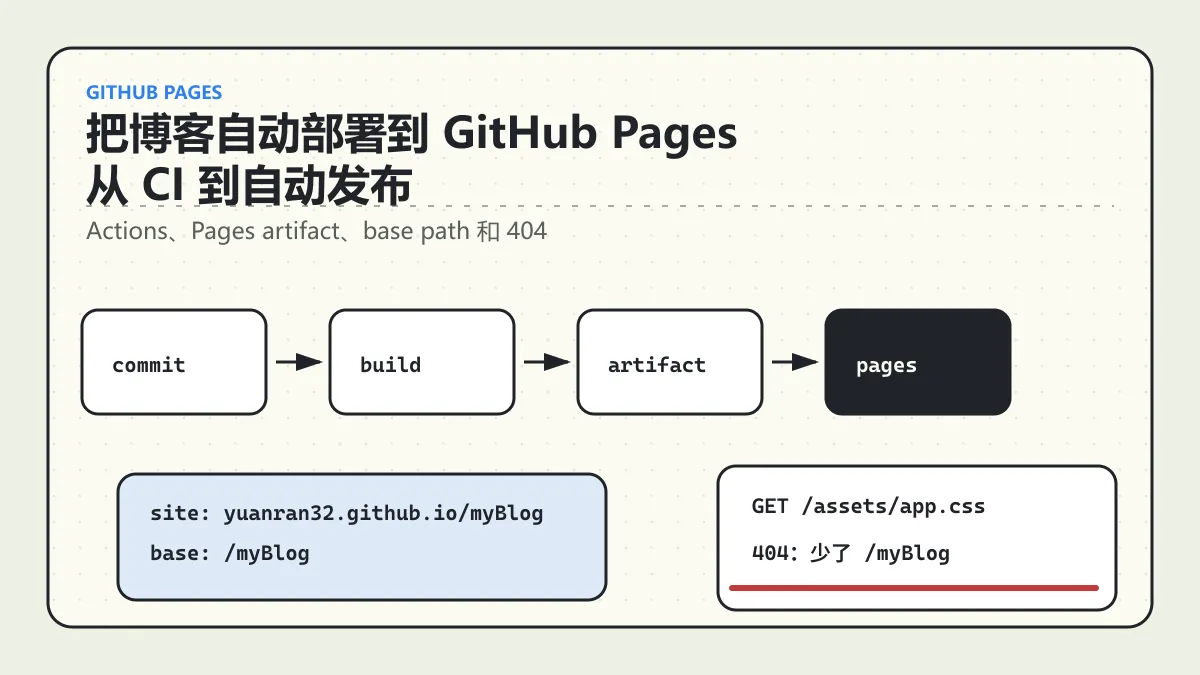
上一篇记录了我用 Astro 把这个博客从零搭起来的过程,选型、内容管理、样式都聊到了,唯独部署只在结尾草草提了一句 base path 的坑。
原因很简单:当时我根本没做自动部署。
那会儿我的”上线”流程是这样的:本地 pnpm build,把 dist/ 整个目录的产物手动推到 gh-pages 分支,然后等 GitHub Pages 刷新。听起来没几步,但实际用起来全是摩擦:
- 改一个错别字也要本地构建一次,慢
- 偶尔忘了 build 直接推了旧产物,线上和源码对不上
- 换台电脑写文章,环境没装好,根本发不了
写博客本来是想降低记录的门槛,结果每次发布都像在过一道关。所以这篇就专门讲讲,我是怎么把这套手动流程换成”push 上去就自动上线”的,以及中间踩的那些坑。
先搞清楚:项目页和那个 /myBlog 到底是什么
要讲部署,绕不开 base path,因为我后面大半的坑都和它有关。
GitHub Pages 有两种站点。一种是用户页,地址是 username.github.io,挂在域名根目录。另一种是项目页,地址是 username.github.io/仓库名,挂在一个子路径下。
我这个博客的仓库叫 myBlog,用的是项目页,所以线上地址其实是:
https://yuanran32.github.io/myBlog/注意结尾那个 /myBlog/。整个站点不是挂在根目录,而是挂在 /myBlog 这个子路径下面。这件事在本地开发时完全感知不到——本地 localhost:4321 就是根目录,怎么写都对。但一上线,所有从根目录 / 开始的绝对路径就全错了。
所以 astro.config.mjs 里这两行必须配对:
export default defineConfig({
  site: 'https://yuanran32.github.io/myBlog',
  base: '/myBlog'
  // ...
});
base 和 site 是两件事,我一开始还把它们搞混过:
base是路径前缀,告诉 Astro “我的站点挂在/myBlog下”,它会用这个值去拼内部资源路径site是完整域名,sitemap、RSS、canonical 链接、Open Graph 这些需要绝对 URL 的地方会用它
base 写错,本地能跑,线上白屏;site 写错,页面正常,但 RSS 和 SEO 里的链接全是坏的。后者更隐蔽,因为你平时根本不会去点 RSS 里的链接。
项目页部署的第一课:你以为站点在
/,其实它在/仓库名。
这个认知错位,是后面所有 404 的根源。
第一版:我只有 CI,没有 CD
搭博客的时候我先写了一个 CI workflow,就是仓库里那个 .github/workflows/ci.yml,它长这样:
name: CI

on:
  push:
    branches: [master, main]
  pull_request:
    branches: [master, main]

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Setup pnpm
        uses: pnpm/action-setup@v4
        with:
          version: 10

      - name: Setup Node
        uses: actions/setup-node@v4
        with:
          node-version: 22
          cache: pnpm

      - name: Install dependencies
        run: pnpm install --frozen-lockfile

      - name: Check formatting
        run: pnpm run format:check

      - name: Run Astro check
        run: pnpm run check

      - name: Build site
        run: pnpm run build
这个 workflow 帮了我不少忙:每次 push,它会检查 Prettier 格式、跑 astro check 做类型和内容校验、再完整构建一遍。只要这一步绿了,我就知道至少代码是能编译、内容 frontmatter 没写错的。
但它有一个很关键的缺口:它只构建,不发布。
pnpm run build 把产物生成在 CI runner 的 dist/ 里,然后这个 job 一结束,产物就跟着 runner 一起销毁了。它证明了”能 build 出来”,但没把 build 出来的东西送到任何人能访问的地方。
这就是 CI 和 CD 的区别。我当时有的是 CI(持续集成,保证代码是好的),缺的是 CD(持续部署,把好的代码送上线)。手动推 dist/ 这一步,就是我用人肉在补 CD。
加上自动部署
GitHub Pages 现在支持直接用 GitHub Actions 部署,不用再维护一个 gh-pages 分支了。整个思路就两步:
- 一个 job 负责 build,把产物打包成 Pages artifact 上传
- 另一个 job 负责把这个 artifact 发布到 Pages
我新加了一个 .github/workflows/deploy.yml:
name: Deploy to GitHub Pages

on:
  push:
    branches: [master]

permissions:
  contents: read
  pages: write
  id-token: write

concurrency:
  group: pages
  cancel-in-progress: false

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Setup pnpm
        uses: pnpm/action-setup@v4
        with:
          version: 10

      - name: Setup Node
        uses: actions/setup-node@v4
        with:
          node-version: 22
          cache: pnpm

      - name: Install dependencies
        run: pnpm install --frozen-lockfile

      - name: Build
        run: pnpm run build

      - name: Upload artifact
        uses: actions/upload-pages-artifact@v3
        with:
          path: ./dist

  deploy:
    needs: build
    runs-on: ubuntu-latest
    environment:
      name: github-pages
      url: ${{ steps.deployment.outputs.page_url }}
    steps:
      - name: Deploy to GitHub Pages
        id: deployment
        uses: actions/deploy-pages@v4
这里有几个地方是我照着官方文档抄、但抄完才真正理解为什么的。
permissions 这三行不能省。 pages: write 是发布权限,id-token: write 是给 OIDC 用的——deploy-pages 需要拿一个短期 token 来证明”这次部署是这个 workflow 发起的”。我第一次漏了 id-token: write,deploy job 直接报权限错误,盯着日志看了好一会儿才反应过来。
concurrency 是防自己踩自己。 如果我连着 push 两次(比如发完文章又改了个错别字),两个部署会同时跑。group: pages 保证同一时间只有一个 Pages 部署在进行。cancel-in-progress: false 这个我特意设成 false——部署这种事,宁可排队等前一个发完,也不要发到一半被取消,避免线上出现半新半旧的状态。
upload-pages-artifact 的 path 要指向 dist。 Astro 默认就输出到 dist/,这里写对就行。这个 action 会把目录打包成 Pages 专用的 artifact 格式,下游的 deploy-pages 才认。
build 和 deploy 拆成两个 job。 deploy 用 needs: build 等 build 完成。拆开的好处是职责清晰,而且只有 deploy 这个 job 需要那套敏感权限,build 阶段不碰发布权限,更安全。
顺带一提,Astro 官方还提供了一个 withastro/action,能把 build 那一堆步骤(装包管理器、装依赖、build、upload artifact)压成一行:
- uses: withastro/action@v3它会自动探测你用的是 npm/pnpm/yarn。我自己更喜欢把步骤写开,因为出问题时一眼能看到卡在哪一步;但如果你想要简洁,用官方 action 完全没问题。
最容易忘的一步:仓库设置里改 Source
workflow 写好推上去,我满怀期待地等部署,结果 deploy job 一直失败。
折腾半天才发现,问题根本不在代码里,而在仓库设置:
Settings → Pages → Build and deployment → Source,必须从 “Deploy from a branch” 改成 “GitHub Actions”。
GitHub Pages 默认是”从某个分支部署”模式——它盯着 gh-pages 或 main 分支的产物。只有把 Source 切到 “GitHub Actions”,deploy-pages 这个 action 才有地方把内容发出去。
这一步纯粹是点几下鼠标,没有任何代码,所以特别容易在写完 workflow 后忘掉。我把它单独拎出来说,是因为当时我对着 YAML 反复检查,完全没往设置上想,白白浪费了二十分钟。
部署成功了,然后页面白屏
切好设置、workflow 跑绿,我打开 https://yuanran32.github.io/myBlog/——白屏。
打开 F12,Network 面板红了一片,全是 404:
GET https://yuanran32.github.io/assets/index.abc123.css  404
GET https://yuanran32.github.io/dot-grid.js              404
看出问题了吗?这些请求都打到了 github.io/assets/...,少了 /myBlog 这一段。它们应该是 github.io/myBlog/assets/... 才对。
这就是开头说的 base path 错位。Astro 对组件里 import 进来的资源、对 <a href> 大多能自动加上 base 前缀,但有两类东西它管不了:
public/目录下的静态文件(我那个dot-grid.js就在 public 里)- 我自己手写的、以
/开头的绝对路径
解决办法上一篇提过,就是封装一个 withBase(),把所有内部链接和资源都过一遍:
export function withBase(path: string): string {
  const base = import.meta.env.BASE_URL;
  if (path.startsWith('http') || path.startsWith(base)) return path;
  return base + path.replace(/^\//, '');
}
用的时候:
<script src={withBase('/dot-grid.js')}></script>
<link rel="stylesheet" href={withBase('/custom.css')} />
import.meta.env.BASE_URL 在 Astro 里就是配置的 base,所以本地(base 实际上仍是 /myBlog)和线上拿到的值是一致的,不用写死。
那次白屏之后我专门全局搜了一遍 href="/ 和 src="/,把漏网的几个绝对路径都补上了 withBase()。这种坑的麻烦之处在于:本地 pnpm dev 大概率看不出来,因为开发服务器对路径更宽容。
怎么在本地就复现线上的 404
被白屏坑过一次后,我学乖了,发布前会先在本地用接近生产的方式验证一遍。
关键区别是 astro dev 和 astro preview 两个命令:
pnpm dev跑的是开发服务器,对路径处理比较松,base 相关的问题经常被它”兜”过去pnpm preview跑的是构建后产物的预览,行为和线上几乎一致,base path 错了它就会原样 404
所以现在我的习惯是,改完部署相关的东西,先:
pnpm build
pnpm preview
然后访问 http://localhost:4321/myBlog/,特意带上 /myBlog 这段去点几个页面、看几个资源。能在本地复现的 404,就不用等推上去之后再发现。
部署相关的问题,要用最接近生产的方式去测。
dev太宽容,preview才说真话。
404 页面也要管一下
还有个细节:用户访问一个不存在的路径时,GitHub Pages 会去找站点根目录下的 404.html。
如果你不提供,它会显示 GitHub 默认的那个 404 页,和你的博客毫无关系,挺出戏的。Astro 的处理很简单,在 src/pages/ 下放一个 404.astro,build 时它会自动产出 404.html:
---
import BaseLayout from '../layouts/BaseLayout.astro';
---

<BaseLayout title="页面没找到">
  <h1>404</h1>
  <p>这个页面可能被我删掉了,或者链接本来就不对。</p>
  <a href={withBase('/')}>回首页</a>
</BaseLayout>
这样未知路径也能套上博客自己的布局,体验一致。
部署成功但看到的还是旧内容
最后这个坑很常见,也很容易让人怀疑人生:deploy job 明明绿了,刷新页面内容却没变。
我遇到过两种情况:
一种是真的没发完。Actions 里 build 绿了不代表上线了,deploy job 还在后面跑。我有几次看到 build 完成就去刷新,其实 deploy 还没结束。养成习惯看 deploy 那个 job 的状态,它会给一个 page_url,跑完才算真上线。
另一种是浏览器缓存。CSS、JS 这些静态资源缓存得比较狠,普通刷新可能还是旧的。硬刷新(Ctrl+Shift+R)或者无痕窗口打开,基本就能确认到底是缓存问题还是真没发上去。
排查顺序我现在固定成:先确认 deploy job 真的结束了 → 再硬刷新排除缓存 → 还不对才回头查产物。这个顺序能省掉很多”我代码到底改了没”的自我怀疑。
现在的发布流程
折腾完之后,我的发布流程变成了这样:
- 本地写文章、改样式,需要的话
pnpm preview验证一下 git push到master- CI workflow 跑检查(格式、类型、构建)
- Deploy workflow 自动 build 并发布到 GitHub Pages
- 等 deploy job 结束,硬刷新看效果
从”本地构建 + 手动推产物”,变成了”push 完就不用管”。写错别字也不再有心理负担——改完推上去,剩下的交给 Actions。
这件事带来的真正变化,不是少敲了几行命令,而是让我更愿意写了。以前发布有摩擦,就会攒着改、懒得发;现在发布几乎零成本,反而更新得更勤。
最后
回头看,把博客部署上线这件事,技术上其实没多复杂——核心就是一个 build job、一个 deploy job、再加几行权限。真正费时间的,全是那些”本地好好的,线上就不行”的环境差异:base path、缓存、设置里那个没切的 Source。
这些坑有个共同点:它们都来自”我以为的运行环境”和”真实的运行环境”不一致。本地是根目录,线上是子路径;dev 很宽容,生产很较真;build 绿了,不代表发布完了。
所以如果让我总结一句给同样在折腾 GitHub Pages 部署的人,大概是:
别只信本地,也别只信”绿灯”。用最接近生产的方式去验证,坑会少一大半。
部署不是写博客的终点,它只是把”写完”和”上线”之间的那段距离尽量抹平。这段距离越短,我就越愿意把脑子里的东西写下来——对一个博客来说,这可能比任何技术选型都重要。